1. Skąd biorą się ukryte znaki wodne w tekstach z ChatGPT i Claude
Kiedy prosicie sztuczną inteligencję o przygotowanie wpisu, podsumowania czy raportu, odpowiedź na ekranie wygląda zupełnie naturalnie. Zwykłe polskie słowa, logiczne zdania, brak widocznych pieczątek. W praktyce plik nie jest czysty. Claude (Anthropic) i ChatGPT po cichu dodają niewidzialne wzorce w strukturze zdań i spacji.
To nie jest znak wodny ze zdjęcia. Dla oka nic nie widać. Dla detektora — programu, który sprawdza, czy tekst pisał człowiek, czy maszyna — te wzorce są jak latarnia. Dlatego detektor od razu wie, że tekst pisała sztuczna inteligencja.
„Claude i ChatGPT po cichu dodają do generowanych odpowiedzi niewidzialne wzorce w strukturze zdań i spacji. Przez to każdy detektor od razu wie, że tekst pisała sztuczna inteligencja.”
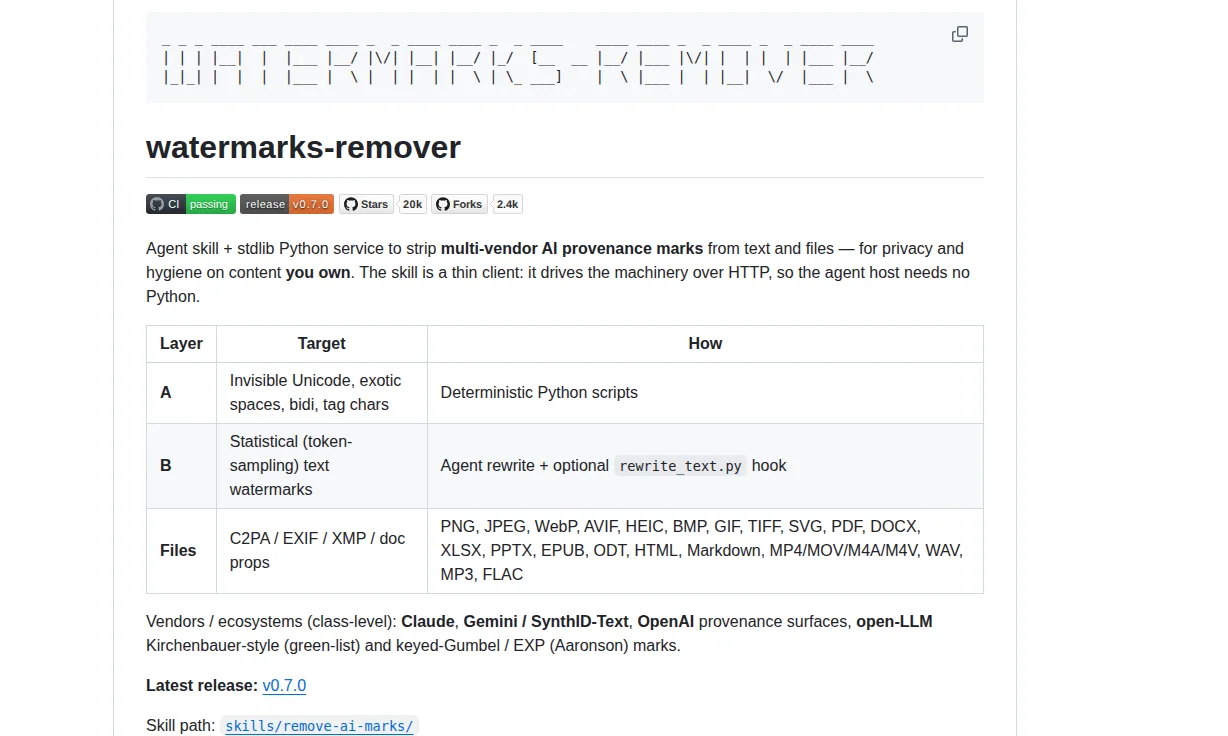
Na GitHubie — publicznym katalogu z darmowym kodem — pojawił się skrypt, który te ślady czyści. Poniżej jest konkretne repozytorium, zrzuty z jego strony i polecenie instalacji z oficjalnego README.
2. Dwie warstwy śladów: spacje i układy tokenów
Sztuczna inteligencja zostawia odcisk w dwóch miejscach. Oficjalne README projektu nazywa to warstwą A, warstwą B i osobno plikami z metadanymi.
Claude i ChatGPT wplatają specyficzne odstępy oraz niewidoczne znaki kontrolne. W edytorze widzicie zwykłą spację. Detektor czyta kody znaków i widzi schemat. W README: Invisible Unicode, exotic spaces, bidi, tag chars.
Token to mały kawałek słowa, na które model dzieli tekst. Model celowo układa kolejne kawałki tak, by powstał powtarzalny, matematyczny rytm. Dla ucha brzmi płynnie. Dla algorytmu to dowód, że pisała maszyna. W README: statistical (token-sampling) text watermarks.
Oprócz tekstu modele bywają podpinane do metadanych C2PA / EXIF / XMP — niewidocznego podpisu twórcy modelu. Skrypt czyści też tę warstwę w plikach (PDF, DOCX, HTML, Markdown i inne z listy README).
 Powiększ HD
3. Darmowy skrypt z GitHuba: watermarks-remover
Prywatnościowy skrypt, który zdejmuje znaki wodne AI z treści, które już macie. README: warstwa A (Unicode i spacje), warstwa B (ślady tokenów) oraz metadane C2PA w plikach. Claude, ChatGPT / OpenAI, Gemini.
Projekt watermarks-remover to darmowy skrypt — mały program do jednego zadania. Wrzucacie wygenerowany artykuł, narzędzie usuwa matematyczne ślady i układy tokenów. Nie przepisuje Wam zdań synonimami. Czyści ślady, zostawia treść.
Jak zainstalować (z oficjalnego README)
Otwórzcie terminal, pobierzcie kod z GitHuba i odpalcie instalator z README. Python 3.10+, bez dodatkowych bibliotek do samego instalatora:
git clone https://github.com/guillaumemeyer/watermarks-remover.git
cd watermarks-remover
python3 install_skill.py --skill remove-ai-marks --target claude-code
Ten sam instalator obsługuje Cursor (--target cursor) i paczka dla Cowork / claude.ai (--target cowork). Szczegóły są w tabeli Host / Target w README.
4. Jak usunąć ukryte znaki wodne w trzech krokach
Cały proces sprowadza się do trzech etapów. Wrzucacie tekst, skrypt szuka wzorców, kasuje znaczniki.
Kopiujecie wygenerowany przez Claude albo ChatGPT artykuł i wklejacie go do narzędzia. Akapit, post albo dłuższy dokument.
Skrypt analizuje matematyczne ślady tokenów, spacje i niewidzialne znaki. Porównuje je ze znanymi regułami znakowania.
Algorytm kasuje ukryte znaczniki i spacje oraz odcina zaszyfrowane metadane. Na planszy procesu: ZERO ŚLADÓW AI.
„Wrzucasz tam wygenerowany artykuł, a narzędzie usuwa matematyczne ślady i układy tokenów.”
5. Czysty tekst zamiast płatnych parafraz
Zamiast płacić za drogie programy, które przepisują zdania synonimami, dostajecie czysty tekst bez śladów, które widzą algorytmy. Parafraza często psuje język. Ten skrypt nie zamienia słów — zdejmuje niewidzialną warstwę.
- Zero abonamentu: narzędzie jest darmowe (0 zł), oszczędzacie na programach humanizujących.
- Sens zostaje: usuwane są wzorce i spacje, nie Wasze zdania.
„Zamiast płacić za drogie parafrazy, dostajesz czysty tekst nie do wykrycia przez algorytmy.”
| Porównanie | Płatne parafrazy | Darmowy skrypt z GitHuba |
|---|---|---|
| Koszt | Regularny abonament | Bezpłatnie (0 zł) |
| Co robi z tekstem | Przepisuje zdania | Czyści spacje, tokeny i metadane |
| Styl | Często sztuczne synonimy | Zostaje Wasz język |
6. Prywatność i metadane twórców modeli
Stawka to prywatność i kontrola nad własnym materiałem. Nie ma powodu, żeby firmowa notatka niosła zaszyfrowany podpis korporacji, która wygenerowała szkic.
„Masz pełną prywatność i czysty tekst bez żadnych zaszyfrowanych metadanych twórców modeli.”
README projektu czyści C2PA / EXIF / XMP oraz właściwości dokumentów. Publikujecie albo odsyłacie dalej tekst bez ukrytych trackerów, bez nienaturalnych spacji i bez matematycznych śladów, które czytają zewnętrzne algorytmy.